9.2 기술통계
9.2 기술통계
학생 30명의 시험 점수처럼 데이터가 30개, 300개, 3만 개로 늘어나면 값을 하나하나 눈으로 살펴보는 것만으로는 "이 반의 성적이 대체로 어떤 수준인지", "점수가 고르게 퍼져 있는지 아니면 소수의 학생에게 쏠려 있는지"를 파악하기 어렵습니다.
아래처럼 점수를 그대로 늘어놓으면 전체적인 경향을 한눈에 알기 어렵지만,
"평균 84.7점, 표준편차 약 9.9점, 중앙값 87.5점"처럼 몇 개의 숫자로 요약하면 반 전체의 성적 수준과 흩어진 정도를 훨씬 빠르게 파악할 수 있습니다.
이처럼 데이터 전체를 대표하는 몇 개의 수치로 압축하는 작업을 기술통계(descriptive statistics)라고 하며, 크게 다음 네 가지 질문으로 나눌 수 있습니다.
- 데이터를 대표하는 값은 무엇인가? → 중심경향값(mean(), weighted.mean(), median())
- 데이터가 대표값 주변에 얼마나 퍼져 있는가? → 산포도(var(), sd(), range(), IQR(), mad())
- 데이터를 몇 개의 대표적인 지점으로 나누면 어떤 모습인가? → 사분위수와 요약(quantile(), fivenum(), summary())
- 데이터의 양 끝은 어디인가? → 최댓값·최솟값(max(), min(), pmax(), pmin())
- 두 변수는 서로 어떤 관계가 있는가? → 공분산과 상관계수(cov(), cor())
- 데이터의 순서 자체가 필요하다면? → 순위와 정렬(rank(), sort(), order())
기술통계는 표본(sample) 데이터의 분포적 특징(중심·산포·형태·관계·순서)을 하나 또는 몇 개의 요약 통계량(summary statistic)으로 나타내는 방법론입니다. 이 절에서 다루는 함수는 모두 수치형(numeric) 벡터를 대상으로 합니다. 성별·혈액형처럼 범주형(categorical) 자료의 도수(빈도)를 요약하려면 table() 함수를 사용합니다.
⚠️ 결측값(NA) 처리 공통 주의사항: 이 절의 거의 모든 함수는
na.rm인자를 공통으로 갖고 있으며, 기본값은FALSE입니다. 즉 데이터에 결측값이 단 하나라도 섞여 있으면 별도로na.rm = TRUE를 지정하지 않는 한 계산 결과가 통째로NA가 되어버립니다. 실제 데이터에는 결측값이 섞여 있는 경우가 흔하므로, 계산 결과가 뜻밖에NA로 나온다면 가장 먼저na.rm인자를 의심해 보시기 바랍니다.
아래 표는 9.2절에서 다루는 함수를 한눈에 볼 수 있도록 정리한 것입니다.
| 분류 | 함수 | 반환값 |
|---|---|---|
| 중심경향값 | mean() |
산술평균 |
weighted.mean() |
가중평균 | |
median() |
중앙값 | |
| 산포도 | var() |
분산 |
sd() |
표준편차 | |
range() |
최솟값·최댓값 (범위) | |
IQR() |
사분범위(Q3 − Q1) | |
mad() |
중위수 절대편차 | |
| 사분위수·요약 | quantile() |
분위수 |
fivenum() |
다섯 수치 요약 | |
summary() |
다섯 수치 요약 + 평균 | |
| 최댓값·최솟값 | max() / min() |
벡터 전체의 최댓값·최솟값 |
pmax() / pmin() |
여러 벡터의 원소별 최댓값·최솟값 | |
| 관계 | cov() |
공분산 |
cor() |
상관계수 | |
| 순위·정렬 | rank() |
순위(순위 색인) |
sort() |
정렬된 값 | |
order() |
정렬 순서(위치 색인) |
중심경향값
"이 반의 점수는 대체로 몇 점인가?"라는 질문에는 데이터 전체를 대표하는 값 하나가 필요합니다. 그런데 대표값을 구하는 방법은 한 가지가 아니며, 데이터의 특성(이상치 유무, 관측치의 중요도 차이 등)에 따라 적절한 방법이 달라집니다.
직원 11명의 월급 데이터에 CEO 연봉처럼 유난히 큰 값이 하나 섞여 있으면, 단순 산술평균은 대부분 직원의 체감과 크게 어긋나는 값이 되기 쉽습니다.
mean()은 모든 값에 동일한 비중을 두는 산술평균, weighted.mean()은 관측치마다 서로 다른 가중치(중요도)를 반영한 평균, median()은 정렬했을 때 정중앙에 위치한 값입니다. 중앙값은 극단값의 영향을 거의 받지 않는다는 점에서 이상치가 있는 데이터의 대표값으로 평균보다 안정적일 때가 많습니다.
mean()
mean(x, trim = 0, na.rm = FALSE, ...)는 데이터 x의 산술평균을 반환합니다. 계산식은 n개의 값이 있을 때 x̄ = (x₁ + x₂ + ... + xₙ) / n입니다.
x: 평균을 구할 숫자 벡터, 논리 벡터(TRUE/FALSE), 또는 날짜·시간 객체. 논리 벡터를 넣으면 TRUE는 1, FALSE는 0으로 계산되므로, 조건을 만족하는 비율을 구하는 용도로도 자주 쓰입니다.trim: 정렬된 데이터의 양쪽 극단에서 이 비율(0 ~ 0.5)만큼씩 제외하고 평균을 계산합니다. 이상치가 평균을 왜곡할 우려가 있을 때, 극단값을 아예 제외한 절사평균(trimmed mean)을 구하는 용도입니다. 기본값 0은 아무것도 제외하지 않음을 뜻합니다.na.rm:TRUE이면 결측값(NA)을 제외하고 계산합니다(기본값FALSE).
x <- c(0:10, 50)
mean(x)              # 이상치 50 때문에 대부분 값(0~10)보다 평균이 높게 나옴
#> [1] 8.75

mean(x, trim = 0.1)   # 양 극단 10%(약 1개씩)를 제외하고 계산 → 이상치 영향이 줄어듦
#> [1] 5.5
# 논리 벡터의 평균 = TRUE의 비율 (실무에서 매우 자주 쓰이는 관용구)
pass_flag <- c(TRUE, FALSE, TRUE, TRUE, TRUE)
mean(pass_flag)   # 5명 중 4명이 TRUE → 80%
#> [1] 0.8
weighted.mean()
weighted.mean(x, w, na.rm = FALSE)는 가중치 w를 적용한 데이터 x의 가중평균을 반환합니다.
x: 평균을 구할 숫자 벡터w: x와 길이가 같은 가중치 벡터. 값이 클수록 해당 관측치가 평균에 더 크게 반영됩니다.na.rm:TRUE이면 x의 결측값과 그에 대응하는 가중치를 함께 제외하고 계산합니다.
모든 관측치의 중요도가 같지 않을 때(예: 학점별로 이수 학점 수가 다른 과목 평점 계산) 단순 평균 대신 가중평균을 씁니다. 계산식은 Σ(wᵢ × xᵢ) / Σwᵢ이며, 가중치를 모두 같은 값으로 주면 산술평균과 동일한 결과가 됩니다.
x <- c(3.7, 3.3, 3.5, 2.8)      # 과목별 평점
wt <- c(5, 5, 4, 1)/15           # 과목별 이수 학점 비중
weighted.mean(x, w = wt)         # 학점 가중 평균 평점
#> [1] 3.453333
x <- c(9, 5, 2, 7, 3, 6, 4, 5, NA)
wt <- c(2, 3, 1, 5, 7, 1, 3, 7, 3)
weighted.mean(x, w = wt, na.rm = TRUE)
#> [1] 4.965517
median()
median(x, na.rm = FALSE, ...)는 데이터 x의 중앙값(중위수)을 반환합니다.
x: 숫자 또는 논리 벡터, 날짜·시간 객체na.rm:TRUE이면 결측값을 제외하고 계산
관측치 개수가 짝수이면 가운데 두 값의 평균을, 홀수이면 정중앙의 값을 그대로 반환합니다.
median(c(1, 2, 3, 4))       # 짝수 개 → 가운데 두 값(2, 3)의 평균
#> [1] 2.5

median(c(1, 2, 3, 4, 5))    # 홀수 개 → 정중앙 값
#> [1] 3
💡 언제 평균 대신 중앙값을 볼까요? 평균은 모든 값을 계산에 반영하므로 이상치 하나에도 크게 흔들리지만, 중앙값은 "가운데 위치"만 보므로 이상치의 영향을 거의 받지 않습니다. 아파트 가격·소득처럼 소수의 매우 큰 값이 존재하는 데이터를 요약할 때, 정부 통계나 언론에서 "평균 소득"이 아니라 "중위 소득"을 함께 제시하는 이유도 여기에 있습니다.
산포도
평균이 같은 두 반이 있다고 해도, 한 반은 대부분 학생이 평균 근처에 몰려 있고 다른 반은 잘하는 학생과 못하는 학생이 극단적으로 갈릴 수 있습니다. 중심경향값만으로는 이 차이를 알 수 없습니다.
두 반의 평균이 똑같이 80점이라도,
class_a <- c(78, 79, 80, 81, 82)   # 평균 근처에 모여 있음
class_b <- c(50, 65, 80, 95, 110)  # 널리 퍼져 있음 (가상의 값)
mean(class_a)
#> [1] 80

mean(class_b)
#> [1] 80
두 반의 실제 학습 격차와 편차 관리 방식은 완전히 다를 수 있습니다.
데이터가 대표값 주변에 얼마나 퍼져 있는지를 나타내는 값을 산포도(measure of dispersion)라고 합니다. var()·sd()는 평균을 기준으로 한 편차를 종합한 값이고, range()는 최솟값과 최댓값의 폭, IQR()은 중앙 50% 데이터의 폭, mad()는 중앙값을 기준으로 한 편차의 중앙값입니다.
var() / sd()
var(x, y = NULL, na.rm = FALSE, use)는 데이터 x의 분산을, sd(x, na.rm = FALSE)는 표준편차를 반환합니다. 분산 s² = Σ(xᵢ - x̄)² / (n - 1), 표준편차 s = √(s²)입니다. (Σ는 i = 1부터 n까지의 합)
x: 숫자 벡터, 행렬, 데이터 프레임y: (var 전용)NULL이 기본값이며, x와 짝을 이루는 숫자 벡터·행렬·데이터 프레임을 지정하면 분산 대신 x와 y의 공분산을 계산합니다(cov()와 동일한 결과).na.rm:TRUE이면 결측값을 제외use: (var 전용) 결측값이 섞여 있을 때의 처리 방법"everything": 결측값이 있으면 결과도NA(기본값)"all.obs": 결측값이 있으면 오류 발생"complete.obs": 결측값이 있는 행을 모두 제외하고 계산"pairwise.complete.obs": 짝이 되는 변수들만 대상으로 결측값이 있는 행을 제외
💡 왜 n이 아니라 n − 1로 나눌까요? 표본으로부터 모집단의 분산을 추정할 때, 표본평균(x̄) 자체가 이미 표본 데이터에 맞춰 계산된 값이라 편차 제곱합이 n으로 나눌 때보다 살짝 작게 나오는 경향이 있습니다. 분모를 n − 1로 보정(자유도 보정, Bessel's correction)하면 이 편향이 없어져 모집단 분산의 불편추정량(unbiased estimator)이 됩니다. R의
var()·sd()는 항상 이 표본 분산·표본 표준편차를 계산하며, 모집단 분산(n으로 나눈 값)을 그대로 반환하는 내장 함수는 없습니다.
var(1:10)
#> [1] 9.166667

sd(1:10)
#> [1] 3.02765

# var()의 계산 과정을 직접 확인
sum((1:10 - mean(1:10))^2) / (10 - 1)
#> [1] 9.166667
var(c(1:10, NA), na.rm = TRUE)
#> [1] 9.166667

var(c(1:10, NA), use = "complete.obs")
#> [1] 9.166667

var(c(1:10, NA), c(5:15), use = "complete.obs")   # y를 지정하면 공분산 계산
#> [1] 9.166667
range()
range(..., na.rm = FALSE, finite = FALSE)는 데이터의 최솟값과 최댓값을 함께 반환합니다.
...: 하나 이상의 숫자 벡터na.rm:TRUE이면 결측값(NA) 제외finite:TRUE이면 결측값뿐 아니라Inf·-Inf·NaN(유한하지 않은 값)까지 모두 제외
x <- c(NA, 1:3, -1:1/0); x    # -1/0=-Inf, 0/0=NaN, 1/0=Inf
#> [1]   NA    1    2    3 -Inf  NaN  Inf

range(x)              # NA가 있으므로 결과도 NA
#> [1] NA NA

range(x, na.rm = TRUE)  # NA만 제외 → 여전히 -Inf, Inf가 남아 결과가 무한대
#> [1] -Inf  Inf

range(x, finite = TRUE) # NA, Inf, NaN을 모두 제외한 뒤 범위 계산
#> [1] 1 3
IQR()
IQR(x, na.rm = FALSE, type = 7)는 데이터의 사분범위(interquartile range)를 반환합니다. 사분범위는 제3사분위수(Q3)에서 제1사분위수(Q1)를 뺀 값으로, 중앙 50%의 데이터가 흩어진 정도를 나타냅니다. 즉 IQR(x) == quantile(x, 0.75) - quantile(x, 0.25)입니다.
x: 사분범위를 구할 숫자 벡터na.rm:TRUE이면 결측값 제외type: 분위수 계산 방식(1~9, 기본값 7).quantile()절에서 자세히 다룹니다.
range()는 최솟값·최댓값 단 두 점만 보므로 이상치 하나에도 크게 흔들리지만, IQR()은 중앙 50%만 보기 때문에 양 끝의 극단값에 영향을 덜 받습니다. 상자그림(18.4 Box Plot)의 상자 높이가 바로 이 사분범위입니다.
x <- c(NA, 1:12, -1:1/0); x
#>  [1]   NA    1    2    3    4    5    6    7    8    9   10   11   12 -Inf  NaN
#> [16]  Inf

IQR(x, na.rm = TRUE)
#> [1] 6.5
mad()
mad(x, center = median(x), constant = 1.4826, na.rm = FALSE, low = FALSE, high = FALSE)는 중위수 절대편차(Median Absolute Deviation)를 반환합니다. 각 값에서 중앙값을 뺀 뒤 절대값을 취하고, 그 값들의 중앙값을 다시 구하는 방식으로 계산합니다.
center: 편차를 계산할 기준값(기본값은median(x))constant: 정규화 상수(기본값 1.4826). 데이터가 정규분포를 따른다면 MAD에 이 상수를 곱한 값이 표준편차(sd)와 비슷한 크기가 되도록 맞춘 값입니다(1 / qnorm(0.75)와 같습니다).na.rm:TRUE이면 결측값 제외low:TRUE이면 관측치 개수가 짝수일 때 두 중앙값 후보 중 작은 값을 사용high:TRUE이면 관측치 개수가 짝수일 때 두 중앙값 후보 중 큰 값을 사용
sd()는 평균과 제곱을 사용하기 때문에 이상치 하나에도 값이 크게 출렁이지만, mad()는 중앙값과 절대값만 사용하므로 이상치에 훨씬 덜 민감한 로버스트(robust) 산포도입니다. 그래서 이상치가 의심되는 데이터의 산포를 볼 때 sd()와 함께 참고하기 좋습니다.
x <- 1:9
mad(x)
#> [1] 2.9652

# mad()의 계산 과정을 직접 재현
median(abs(x - median(x))) * 1.4826
#> [1] 2.9652

# constant = 1.4826의 유래
1 / qnorm(0.75)
#> [1] 1.482602
사분위수와 요약 통계
평균·분산 두 숫자만으로는 데이터의 분포 형태(대칭인지, 한쪽으로 치우쳤는지)까지 알기 어렵습니다. 데이터를 몇 개의 대표적인 위치로 나누어 살펴보면 분포의 모양을 더 구체적으로 파악할 수 있습니다.
시험 점수를 최솟값·최댓값뿐 아니라 하위 25%, 중앙값, 상위 25% 지점까지 함께 보면, 상위권과 하위권이 각각 얼마나 몰려 있는지 가늠할 수 있습니다.
quantile()은 원하는 비율(분위) 어디든 자유롭게 지정할 수 있는 일반적인 도구이고, fivenum()·summary()는 그중 가장 널리 쓰이는 다섯 지점(최솟값·Q1·중앙값·Q3·최댓값)을 표준화해서 보여주는 요약 함수입니다.
p분위수(0 ≤ p ≤ 1)는 데이터를 오름차순 정렬했을 때 아래로부터 비율 p에 해당하는 위치의 값이며, 정확히 그 위치에 데이터가 없을 경우 보간(interpolation) 방식에 따라 여러 계산법이 존재합니다.
quantile()
quantile(x, probs = seq(0, 1, 0.25), na.rm = FALSE, names = TRUE, type = 7, ...)는 데이터 x의 분위수를 반환합니다.
x: 분위수를 구할 숫자 벡터probs: 0과 1 사이의 확률(비율) 벡터. 기본값은c(0, 0.25, 0.5, 0.75, 1)(사분위수)이며, 원하는 비율을 자유롭게 지정할 수 있습니다(예: 상위 5%를 보려면0.95).na.rm:TRUE이면 결측값 제외names:FALSE로 지정하면 결과에 "25%"처럼 비율을 나타내는 이름표를 붙이지 않고 숫자만 반환합니다.type: 분위수를 계산하는 방식(1~9, 기본값 7). 정확히 그 비율 위치에 데이터가 없을 때 어떻게 보간할지를 정합니다.
💡 type 인자, 꼭 알아야 할까요? 대부분은 기본값(7)으로 충분하지만, 통계 소프트웨어마다 분위수 계산 결과가 미묘하게 다르게 나오는 이유가 대부분 이 옵션 차이 때문이므로 알아 두면 유용합니다.
type 방식 비고 1 불연속(계단식) 실제 관측값 중 하나를 그대로 사용 2 불연속(계단식) type 1과 유사, 경계에서 평균 사용 3 불연속(계단식) SAS의 기본값과 유사 4~6 연속(선형보간) 6은 SPSS·Minitab 기본값과 유사 7 연속(선형보간) R의 기본값, Excel QUARTILE·PERCENTILE과 유사8, 9 연속(선형보간) 표본이 모집단에서 왔다는 가정하에 이론적으로 더 타당하다고 알려진 방식
# probs를 지정하지 않으면 사분위수(최솟값, 25%, 50%, 75%, 최댓값)
x <- c(11, 22, 33, 44, 55, 66, 77, 88)
quantile(x)
#>    0%   25%   50%   75%  100%
#> 11.00 30.25 49.50 68.75 88.00

quantile(x, probs = c(0.05, 0.1, 0.9, 0.95))   # 원하는 비율을 자유롭게 지정
#>    5%   10%   90%   95%
#> 14.85 18.70 80.30 84.15
# type에 따라 결과가 달라질 수 있음
quantile(x, type = 1)   # 불연속(계단식) — 실제 데이터 값 그대로
#>   0%  25%  50%  75% 100%
#>   11   22   44   66   88

quantile(x, type = 7)   # 연속(선형보간) — R 기본값
#>    0%   25%   50%   75%  100%
#> 11.00 30.25 49.50 68.75 88.00
fivenum()
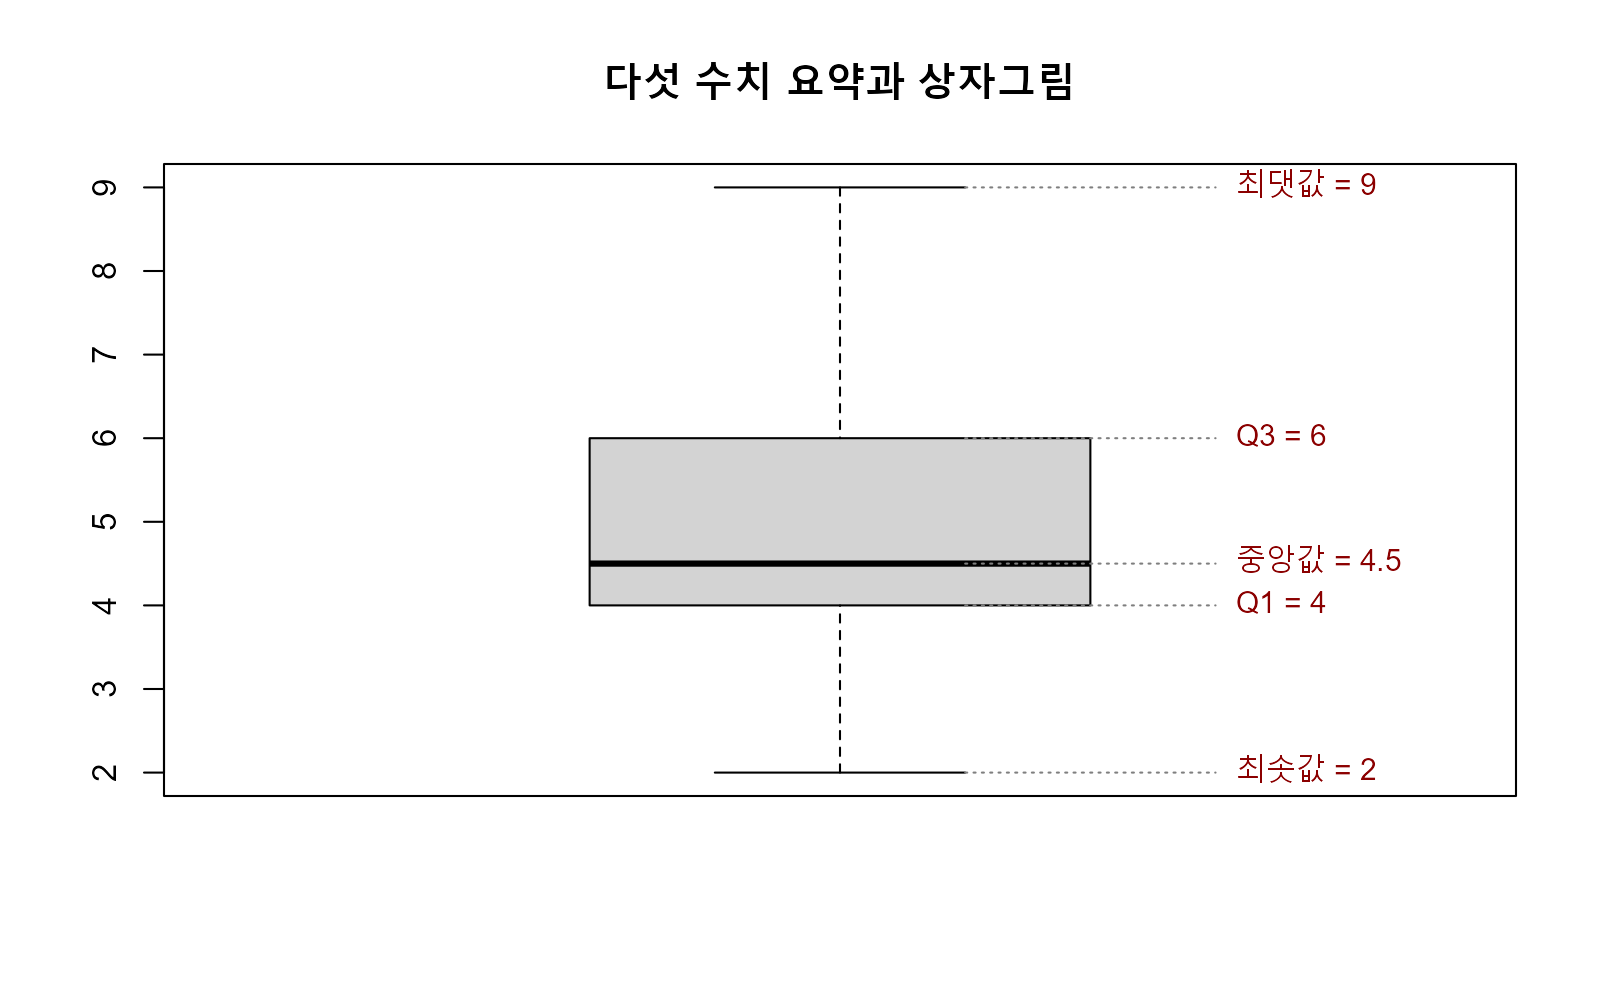
fivenum(x, na.rm = TRUE)는 데이터의 다섯 수치 요약(five-number summary)을 반환합니다. 다섯 수치는 최솟값, 제1사분위수, 중앙값, 제3사분위수, 최댓값이며, 상자그림(Box Plot)의 상자와 수염을 그리는 데 쓰이는 값이기도 합니다.
x: 숫자 벡터na.rm:TRUE(기본값)이면 결측값 제외
fivenum(1:11)
#> [1]  1.0  3.5  6.0  8.5 11.0

summary(1:11)     # 다섯 수치 요약에 평균이 추가된 버전
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
#>     1.0     3.5     6.0     6.0     8.5    11.0
관측치 개수가 짝수일 때는 결과가 조금 다르게 나옵니다. summary()(그리고 quantile())는 분위수를 좀 더 정교한 보간 방식으로 계산하는 반면, fivenum()은 중앙값을 반복해서 찾는 더 단순한 방식(Tukey의 hinge)을 쓰기 때문입니다.
fivenum(1:12)
#> [1]  1.0  3.5  6.5  9.5 12.0

summary(1:12)
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
#>    1.00    3.75    6.50    6.50    9.25   12.00

quantile(1:12, 1/4)
#>  25%
#> 3.75
# fivenum()과 boxplot()의 관계 — 아래 코드를 직접 실행하면 상자그림에서
# 상자의 아래·가운데·위 선이 각각 Q1·중앙값·Q3와 거의 일치함을 확인할 수 있습니다.
x <- c(2, 4, 4, 4, 5, 5, 7, 9)
fivenum(x)
#> [1] 2.0 4.0 4.5 6.0 9.0

bp <- boxplot(x, main = "다섯 수치 요약과 상자그림")
stats <- bp$stats[, 1]
names(stats) <- c("최솟값", "Q1", "중앙값", "Q3", "최댓값")
text(x = 1.3, y = stats,
     labels = paste0(names(stats), " = ", stats),
     pos = 4, cex = 0.9, col = "darkred")
segments(x0 = 1.1, x1 = 1.3, y0 = stats, y1 = stats,
         lty = 3, col = "gray50")
summary()
summary(object, ...)는 객체의 특성을 요약해서 보여주는 범용(generic) 함수입니다. 숫자 벡터에 적용하면 최솟값·1사분위수·중앙값·평균·3사분위수·최댓값 여섯 가지를 한 번에 보여주고, 데이터 프레임에 적용하면 열(변수)마다 이 요약을 각각 계산해 나열합니다.
# women: R에 내장된 데이터셋 - 미국 성인 여성 15명의 키(인치)·몸무게(파운드)
str(women)
#> 'data.frame':    15 obs. of  2 variables:
#>  $ height: num  58 59 60 61 62 63 64 65 66 67 ...
#>  $ weight: num  115 117 120 123 126 129 132 135 139 142 ...

summary(women)
#>      height         weight
#>  Min.   :58.0   Min.   :115.0
#>  1st Qu.:61.5   1st Qu.:124.5
#>  Median :65.0   Median :135.0
#>  Mean   :65.0   Mean   :136.7
#>  3rd Qu.:68.5   3rd Qu.:148.0
#>  Max.   :72.0   Max.   :164.0
summary()는 범용 함수이므로 팩터(factor)에 적용하면 범주별 도수(개수)를, 회귀분석 결과(lm(), 9.3절)에 적용하면 회귀계수·유의확률 등 완전히 다른 내용을 보여줍니다. 즉 같은 함수 이름이라도 입력하는 객체의 클래스(11.1절)에 따라 동작이 달라진다는 점을 기억해 두면, 이후 다른 장에서 summary()를 다시 만나도 당황하지 않을 수 있습니다.
📌 Base R 범위를 벗어난 최신 도구: 왜도(skewness)·첨도(kurtosis)처럼 분포의 비대칭성·뾰족함을 나타내는 통계량이나, 변수별 요약을 표 형태로 더 보기 좋게 정리해 주는 기능은 Base R에는 없고
moments,e1071,skimr,psych(describe()) 같은 외부 패키지에서 제공합니다. 이 매뉴얼은 Base R 전용 범위이므로 다루지 않지만, 실무나 논문에서 좀 더 풍부한 기술통계표가 필요하다면 참고할 만합니다.
최댓값·최솟값
데이터의 양 끝(최솟값·최댓값)을 구하는 가장 기본적인 함수들입니다. max()·min()은 벡터 전체를 통틀어 하나의 값을 반환하지만, pmax()·pmin()은 여러 벡터를 같은 위치끼리 비교해 원소별로 큰(작은) 값을 골라낸다는 점이 다릅니다.
max(..., na.rm = FALSE): 주어진 값들 중 최댓값 반환min(..., na.rm = FALSE): 주어진 값들 중 최솟값 반환pmax(..., na.rm = FALSE): 여러 벡터를 같은 위치끼리 비교해 원소별 최댓값 반환pmin(..., na.rm = FALSE): 여러 벡터를 같은 위치끼리 비교해 원소별 최솟값 반환
max() / min()
x1 <- c(2, 8, 3, 4, 1, 5)
x2 <- c(0, 7, 5, 5, 6, 1)

max(x1)       # x1 전체의 최댓값
#> [1] 8

min(x2)       # x2 전체의 최솟값
#> [1] 0

max(x1, x2)   # x1, x2를 합친 전체 중 최댓값
#> [1] 8
pmax() / pmin()
x1 <- c(2, 8, 3, 4, 1, 5)
x2 <- c(0, 7, 5, 5, 6, 1)

pmax(x1, x2)   # 각 위치에서 더 큰 값만 골라 새 벡터 생성
#> [1] 2 8 5 5 6 5

pmin(x1, x2)   # 각 위치에서 더 작은 값만 골라 새 벡터 생성
#> [1] 0 7 3 4 1 1
na.rm을 지정하지 않으면 max()·min()은 벡터에 NA가 하나만 있어도 전체 결과가 NA가 되지만, pmax()·pmin()은 같은 위치의 다른 벡터에 유효한 값이 있으면 그 값을 대신 사용한다는 차이가 있습니다.
x1 <- c(2, 8, NA, 4, 1, 5)
x2 <- c(NA, 7, 5, 5, 6, 1)
x3 <- c(3, 8, 9, 6, 7, 2)

max(x1)               # NA가 하나라도 있으면 결과 전체가 NA
#> [1] NA

max(x1, na.rm = TRUE)  # NA를 제외하고 계산
#> [1] 8

pmin(x1, x2)             # 두 벡터 모두 NA인 위치(1번째)만 NA로 남음
#> [1] NA  7 NA  4  1  1

pmin(x1, x2, na.rm = TRUE)   # NA 대신 유효한 값이 있으면 그 값을 채택
#> [1] 2 7 5 4 1 1

pmax(x1, x2, x3, na.rm = TRUE)   # 세 벡터를 비교, 매 위치마다 유효한 값 중 최댓값
#> [1] 3 8 9 6 7 5
공분산과 상관계수
키가 클수록 몸무게도 대체로 늘어나는 것처럼, 두 변수가 함께 움직이는 경향이 있는지 알고 싶을 때가 있습니다. 산점도로 눈으로 확인할 수도 있지만, 관계의 강도와 방향을 숫자 하나로 요약하면 여러 변수 쌍을 한 번에 비교하기 편리합니다.
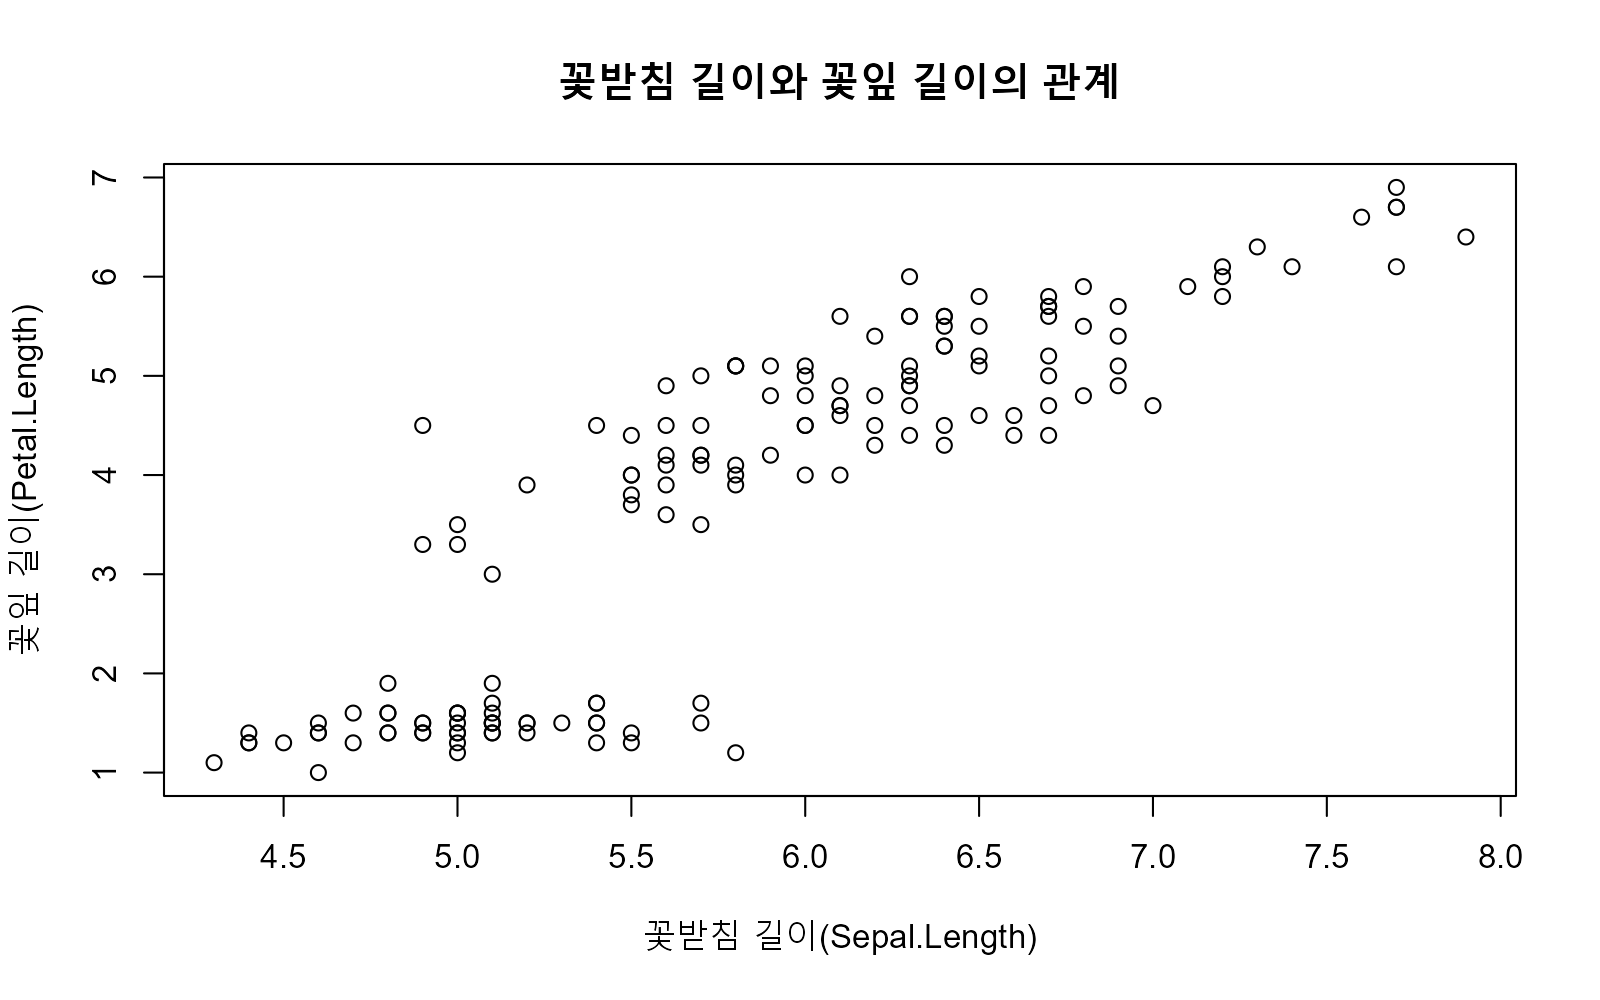
붓꽃 데이터(iris)에서 꽃받침 길이(Sepal.Length)가 커질수록 꽃잎 길이(Petal.Length)도 함께 커지는 경향이 있는지 살펴보겠습니다.
# iris: R에 내장된 데이터셋 - 붓꽃 3종 150개체의 꽃받침·꽃잎 측정값
str(iris)
#> 'data.frame':    150 obs. of  5 variables:
#>  $ Sepal.Length: num  5.1 4.9 4.7 4.6 5 5.4 4.6 5 4.4 4.9 ...
#>  $ Sepal.Width : num  3.5 3 3.2 3.1 3.6 3.9 3.4 3.4 2.9 3.1 ...
#>  $ Petal.Length: num  1.4 1.4 1.3 1.5 1.4 1.7 1.4 1.5 1.4 1.5 ...
#>  $ Petal.Width : num  0.2 0.2 0.2 0.2 0.2 0.4 0.3 0.2 0.2 0.1 ...
#>  $ Species     : Factor w/ 3 levels "setosa","versicolor",..: 1 1 1 1 1 1 1 1 1 1 ...
cov()는 두 변수가 함께 커지는지(양수) 함께 작아지는지(음수)를 보여주지만, 그 크기는 각 변수의 측정 단위에 영향을 받아 변수마다 크기를 비교하기 어렵습니다. cor()는 공분산을 각 변수의 표준편차로 나누어(표준화하여) 단위와 무관하게 항상 −1 ~ 1 사이의 값으로 관계의 강도를 나타냅니다.
공분산의 계산식은 cov(x, y) = Σ(xᵢ - x̄)(yᵢ - ȳ) / (n - 1), 상관계수의 계산식은 cor(x, y) = cov(x, y) / (sx × sy)입니다(sx, sy는 각각 x, y의 표준편차).
cov()
cov(x, y = NULL, use = "everything", method = c("pearson", "kendall", "spearman"))는 데이터 x와 y의 공분산을 반환합니다.
x: 숫자 벡터, 행렬, 데이터 프레임y:NULL이 기본값이며, x와 짝을 이루는 숫자 벡터·행렬·데이터 프레임use: 결측값 처리 방법.var()와 동일하게"everything"(기본값) ·"all.obs"·"complete.obs"·"pairwise.complete.obs"중 선택method: 상관 계산 방식."pearson"(기본값, 선형 관계),"kendall","spearman"(순위 기반, 비선형·이상치에 덜 민감)
# 아래 코드를 직접 실행하면 산점도가 표시되며, 두 변수가 양의 방향으로
# 뚜렷한 선형 관계를 보인다는 것을 눈으로도 확인할 수 있습니다.
plot(iris$Sepal.Length, iris$Petal.Length,
     xlab = "꽃받침 길이(Sepal.Length)", ylab = "꽃잎 길이(Petal.Length)",
     main = "꽃받침 길이와 꽃잎 길이의 관계")
cor()
cor(x, y = NULL, use = "everything", method = c("pearson", "kendall", "spearman"))는 데이터 x와 y의 상관계수를 반환합니다. 인자 구성은 cov()와 동일합니다.
상관계수가 "표준화된 공분산"이라는 정의를 직접 계산으로 확인해 보면 다음과 같이 cor()의 결과와 정확히 일치합니다.
cov(iris$Sepal.Length, iris$Petal.Length) /
  (sd(iris$Sepal.Length) * sd(iris$Petal.Length))
#> [1] 0.8717538
💡 상관계수 해석 시 주의할 점:
cor()는 기본적으로 선형(linear) 관계의 강도만 측정합니다. 두 변수 사이에 뚜렷한 비선형 관계(예: U자 모양)가 있어도 상관계수는 0에 가깝게 나올 수 있으므로, 항상 산점도(plot())와 함께 확인하는 것이 안전합니다. 또한 "상관관계가 있다"는 것이 "한 변수가 다른 변수의 원인이다(인과관계)"를 뜻하지는 않는다는 점도 함께 유의해야 합니다.
순위와 정렬
정렬(sort)은 값을 크기 순서대로 늘어놓는 것이고, 순위(rank)는 "몇 등인지"를 매기는 것이며, 정렬 순서(order)는 "정렬했을 때 원래 몇 번째 자리에 있던 값이 오는지"를 알려주는 것입니다. 이름이 비슷해 헷갈리기 쉽지만 반환하는 정보가 서로 다릅니다.
시험 점수 c(85, 95, 70)이 있다면, sort()는 70 85 95(정렬된 값), rank()는 2 3 1(1번째 학생은 2번째로 작은 값, 2번째 학생은 가장 큰 값, 3번째 학생은 가장 작은 값), order()는 3 1 2(가장 낮은 값은 3번째 학생, 그다음은 1번째 학생, 그다음은 2번째 학생)를 반환합니다.
scores <- c(85, 95, 70)
sort(scores)    # 정렬된 "값"
#> [1] 70 85 95

rank(scores)    # 각 학생의 "등수"
#> [1] 2 3 1

order(scores)   # 정렬했을 때의 "원래 위치"
#> [1] 3 1 2
셋 다 데이터의 순서를 다루지만, 무엇을 반환하느냐(값·순위·위치)가 다릅니다. 특히 order()는 정렬 결과를 원본 데이터 프레임의 여러 열에 함께 적용해야 할 때(예: 점수 순으로 학생 명단 전체를 재배열) 가장 유용합니다.
n개의 값에 대해 sort(x)[i]는 i번째로 작은 값이고, rank(x)[i]는 x[i]가 전체에서 몇 번째로 작은지, order(x)[i]는 i번째로 작은 값이 원래 몇 번째 위치에 있었는지를 나타냅니다. 항상 x[order(x)]와 sort(x)는 동일한 결과를 냅니다.
rank()
rank(x, na.last = TRUE, ties.method = c("average", "first", "last", "random", "max", "min"))는 벡터 x의 순위(순위 색인)를 반환합니다. 정렬된 값이 아니라 "각 원소가 몇 등인지"를 원래 순서 그대로 보여준다는 점에 유의해야 합니다. rank()는 기본적으로 작은 값부터 순위를 매깁니다. 시험처럼 높은 점수가 1등이 되도록 순위를 구하려면 rank(-x)를 사용합니다.
x: 숫자, 문자, 논리 벡터na.last: 결측값(NA) 처리 방법TRUE(기본값) : NA를 가장 낮은 순위(마지막 등수)로 매김FALSE: NA를 가장 높은 순위(1등)로 매김NA: NA를 결과에서 제거"keep": NA를 그대로 NA로 표시ties.method: 동점(tie) 처리 방법"average"(기본값) : 동점자들의 순위를 평균 내어 동일하게 부여"first": 먼저 나온 데이터에 더 높은 순위 부여"last": 나중에 나온 데이터에 더 높은 순위 부여"random": 동점자 사이의 순위를 무작위로 배정"max": 동점자 모두에게 그중 가장 낮은(숫자가 큰) 순위 부여"min": 동점자 모두에게 그중 가장 높은(숫자가 작은) 순위 부여 — 스포츠 순위·시험 등수처럼 일상에서 가장 흔히 쓰는 방식
# 순위값(순위 색인)만 반환하며, 순서대로 재배열하는 것이 아님
x <- c(3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5)
names(x) <- letters[1:11]; x
#> a b c d e f g h i j k
#> 3 1 4 1 5 9 2 6 5 3 5

rank(x)                        # 기본값(average): 동점은 평균 순위
#>    a    b    c    d    e    f    g    h    i    j    k
#>  4.5  1.5  6.0  1.5  8.0 11.0  3.0 10.0  8.0  4.5  8.0

rank(x, ties.method = "min")   # 동점 min 방식(일상에서 가장 많이 쓰는 등수 개념)
#>  a  b  c  d  e  f  g  h  i  j  k
#>  4  1  6  1  7 11  3 10  7  4  7
x <- c(3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, NA); x
#>  [1]  3  1  4  1  5  9  2  6  5  3  5 NA

rank(x, na.last = FALSE)  # NA를 1등으로 처리
#>  [1]  5.5  2.5  7.0  2.5  9.0 12.0  4.0 11.0  9.0  5.5  9.0  1.0

rank(x, na.last = NA)     # NA를 아예 제거
#>  [1]  4.5  1.5  6.0  1.5  8.0 11.0  3.0 10.0  8.0  4.5  8.0
sort()
sort(x, decreasing = FALSE, na.last = NA, ...)는 데이터 x를 정렬한 값을 반환합니다.
x: 숫자, 문자, 논리 벡터decreasing: 기본값FALSE(오름차순),TRUE이면 내림차순na.last: 결측값 처리 방법NA(기본값) : 결측값을 결과에서 아예 제외(제거)TRUE: 결측값을 마지막에 배치FALSE: 결측값을 맨 앞에 배치
x <- c(3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5)
sort(x)
#>  [1] 1 1 2 3 3 4 5 5 5 6 9

sort(x, decreasing = TRUE)
#>  [1] 9 6 5 5 5 4 3 3 2 1 1
문자 벡터에도 그대로 적용되어 사전식(알파벳·가나다) 순서로 정렬됩니다.
order()
order(..., na.last = TRUE, decreasing = FALSE, method = c("auto", "shell", "radix"))는 데이터를 정렬하는 데 필요한 위치(색인)를 반환합니다. 즉 정렬했을 때 각 순위의 값이 원래 벡터에서 몇 번째 자리에 있었는지를 알려줍니다.
...: 숫자, 문자, 논리 벡터. 여러 개를 지정하면 첫 번째 기준으로 정렬하되 동점일 때 두 번째 기준으로 다시 정렬(다중 기준 정렬)합니다.na.last: 결측값 처리 방법(sort()와 달리 기본값이TRUE, 즉 결측값을 마지막 위치로 보냄)decreasing: 기본값FALSE(오름차순),TRUE이면 내림차순method: 정렬 알고리즘"auto"(기본값) : 데이터 특성에 따라 자동으로"radix"또는"shell"선택"shell": 셸 정렬 알고리즘(비교 기반)"radix": 기수 정렬 알고리즘. 값이 같은 원소의 원래 순서를 그대로 유지하는 안정 정렬(stable sort)이라, 다중 기준으로 정렬할 때 동점 처리가 예측 가능하다는 장점이 있습니다.
x <- c(3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5)
order(x)          # 정렬했을 때 각 순위의 값이 원래 몇 번째 자리였는지
#>  [1]  2  4  7  1 10  3  5  9 11  8  6

x[order(x)]       # order()의 결과로 원본을 인덱싱하면 sort(x)와 완전히 동일
#>  [1] 1 1 2 3 3 4 5 5 5 6 9
order()는 벡터 하나만 정렬할 때보다, 데이터 프레임의 여러 열을 함께 재배열해야 할 때 진가를 발휘합니다.
df <- data.frame(name = c("김민준", "이서연", "박도윤"), score = c(88, 95, 90))
df[order(df$score, decreasing = TRUE), ]   # 점수가 높은 순으로 명단 전체를 재배열
#>     name score
#> 2 이서연    95
#> 3 박도윤    90
#> 1 김민준    88
⚠️
sort()와rank()·order()의 결측값(NA) 기본 처리는 서로 다릅니다.sort()의na.last기본값은NA(결측값 제거)이지만,rank()와order()의na.last기본값은TRUE(결측값을 마지막으로 유지)입니다. 세 함수가 이름도 비슷하고 함께 쓰이는 경우가 많다 보니, 이 기본값 차이를 모르면 "정렬하니 결측값이 사라졌는데, 순위를 매기니 결측값이 남아 있다"는 식으로 혼란스러울 수 있습니다.